Do outro continente ao mesmo nó: como o NARA reduziu a latência de microsserviços distribuídos
Resumo
O resumo da minha dissertação de mestrado: por que microsserviços espalhados pelo mundo pagam caro em latência, como o NARA mantém cada requisição dentro do mesmo nó e o que os testes na AWS, no Azure e num cluster de Raspberry Pi mostraram.
- computação distribuída
- microsserviços
- latência
- roteamento por topologia
- Docker Swarm
O ponto de partida
Quem trabalha com microsserviços conhece a situação: cada serviço, isolado, responde rápido, mas a requisição completa, aquela que o usuário de fato espera, demora mais do que a soma das partes sugere. A pesquisa do meu mestrado em Computação na UBI, em Portugal, partiu de uma das causas desse descompasso: a forma como o Docker Swarm distribui as requisições entre as réplicas dos serviços, sem considerar em que máquina cada uma está.
A pergunta que guiou o trabalho foi esta: uma estratégia de roteamento leve, que conheça a topologia da infraestrutura, consegue reduzir a latência de microsserviços espalhados por nuvens e servidores locais? A resposta virou o NARA (Node-Affinity Routing Agent), um middleware que mantém cada requisição dentro do mesmo nó do começo ao fim. Neste texto eu conto o problema, a solução e, principalmente, o que os números mostraram.
O preço de espalhar tudo pela rede
Quebrar um monolito em microsserviços resolve muita coisa. Cada parte pode ser desenvolvida, publicada e escalada sozinha, em linguagens diferentes, com bancos diferentes. Foi o caminho que Netflix e Amazon popularizaram no começo dos anos 2010, e que a nuvem e os containers tornaram acessível para todo mundo.
Só que essa liberdade tem um custo que aparece na rede. Uma única operação do usuário pode disparar uma cadeia de chamadas internas: o serviço A chama o B, que chama o C, que grava no banco. Quando tudo roda na mesma máquina, essas chamadas são rápidas. Quando cada etapa cai num lugar diferente, cada salto entre máquinas soma latência de rede. E quando as máquinas estão em continentes diferentes, cada salto pode atravessar um oceano.
O detalhe que quase ninguém percebe é que o orquestrador não sabe disso. O Docker Swarm, por exemplo, distribui as requisições entre as réplicas de um serviço sem olhar onde elas estão. Se existe uma cópia do serviço B na mesma máquina que está atendendo a requisição e outra em outro continente, a escolha pode cair na distante. O pipeline vira uma sequência de viagens desnecessárias, que custam tempo e, na nuvem, dinheiro.
Por que não usar as soluções que já existem?
A primeira resposta de muita gente seria: coloca um API Gateway ou um service mesh. Ferramentas como Kong, Istio e Linkerd controlam o tráfego entre serviços e resolvem parte do problema. Mas elas trazem bagagem: sidecars em cada serviço, planos de controle, configuração complexa. E essa bagagem também custa latência. Um estudo de Bremler-Barr e colegas mediu o impacto de ativar o mTLS em diferentes service meshes: a latência subiu 166% no Istio, 99% no Cilium e 33% no Linkerd. Para um time pequeno, um projeto de pesquisa ou uma operação enxuta, é peso demais.
Na literatura, eu encontrei duas linhas principais de ataque ao problema:
- Decidir melhor onde cada serviço roda. Colarusso e colegas usaram rastreamento distribuído para descobrir quais serviços conversam mais e implantá-los juntos, reduzindo o tempo de resposta de operações críticas em até 61%. Khan e Khan modelaram as aplicações como grafos e usaram otimização para posicionar os grupos de serviços. Funciona, mas exige analisar a carga ou resolver um problema de otimização antes da implantação.
- Decidir melhor para onde cada requisição vai. Nguyen e colegas criaram o RAP, uma versão modificada do kube-proxy do Kubernetes que prefere tratar as requisições localmente, e Čilić e colegas propuseram o QEdgeProxy, um balanceador que escolhe instâncias pela qualidade de serviço. Os dois dependem de modificar componentes do orquestrador e de monitoramento contínuo.
Faltava uma peça mais simples: algo que funcionasse depois que os serviços já estivessem implantados, sem mexer no orquestrador e sem tocar na regra de negócio da aplicação. Foi esse espaço que o NARA tentou ocupar.
A ideia: manter a requisição no mesmo nó
O NARA é um roteador sem estado que fica na porta de entrada do sistema. Ele roda em todos os nós do cluster, e cada nó roda uma cópia completa do pipeline de microsserviços. Quando uma requisição chega, o orquestrador escolhe um nó para recebê-la, como sempre. A partir daí, o NARA garante que todo o resto da cadeia aconteça naquele mesmo nó.
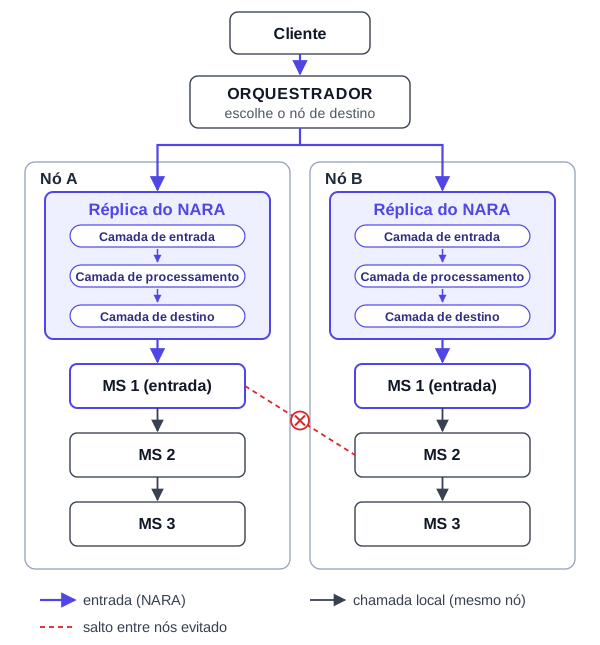
Por dentro, o NARA se organiza em três camadas:
- Camada de entrada: recebe toda requisição externa. Como ela é a única porta de entrada, os serviços internos podem ficar em redes privadas, sem portas expostas.
- Camada de processamento: descobre em qual nó está rodando, lendo o nome da máquina por uma variável de ambiente (como
NODE_HOSTNAME), e decide para qual instância a requisição deve ir. - Camada de destino: encaminha a requisição para o primeiro serviço do pipeline no mesmo nó. Daí em diante, cada chamada continua local.
O ponto forte desse desenho é o que ele não precisa. O NARA não conhece a lógica dos serviços, não guarda estado e só depende do nome do nó e de encaminhamento HTTP comum. Isso faz dele um componente que pode ser colocado na frente de qualquer pipeline que fale HTTP, em qualquer linguagem.
Para que a afinidade funcione na prática, os serviços de negócio são fixados em nós específicos com restrições de posicionamento do Swarm (node.hostname). O banco de dados, por outro lado, fica livre e replicado pelo orquestrador, para continuar disponível independentemente de onde os serviços estejam. E se um nó cair, o Swarm simplesmente para de mandar tráfego para ele, e o NARA segue mantendo a afinidade nos nós que sobraram, sem nenhuma coordenação extra.
Um dashboard para montar a arquitetura
Configurar tudo isso à mão, com réplicas, regiões e restrições de posicionamento, é trabalhoso e fácil de errar. Por isso, junto com o middleware, eu desenvolvi um dashboard que gera o arquivo docker-compose a partir de uma descrição visual da arquitetura. O fluxo tem três passos.
Primeiro, você modela o pipeline: escolhe qual microsserviço recebe as requisições do NARA, quantas réplicas cada serviço terá e como eles se conectam.
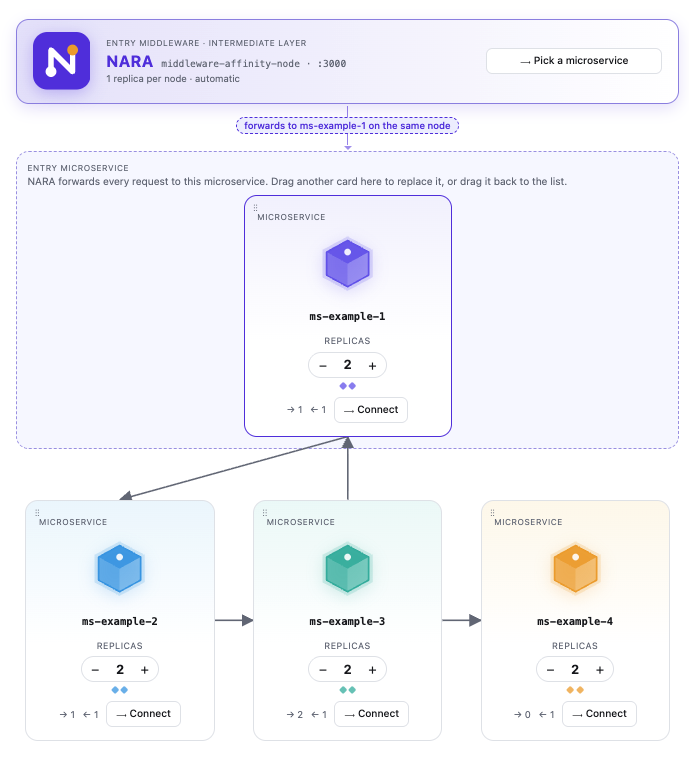
Depois, escolhe os provedores (AWS, Azure, GCP ou infraestrutura própria) e as regiões em que os clusters serão criados.
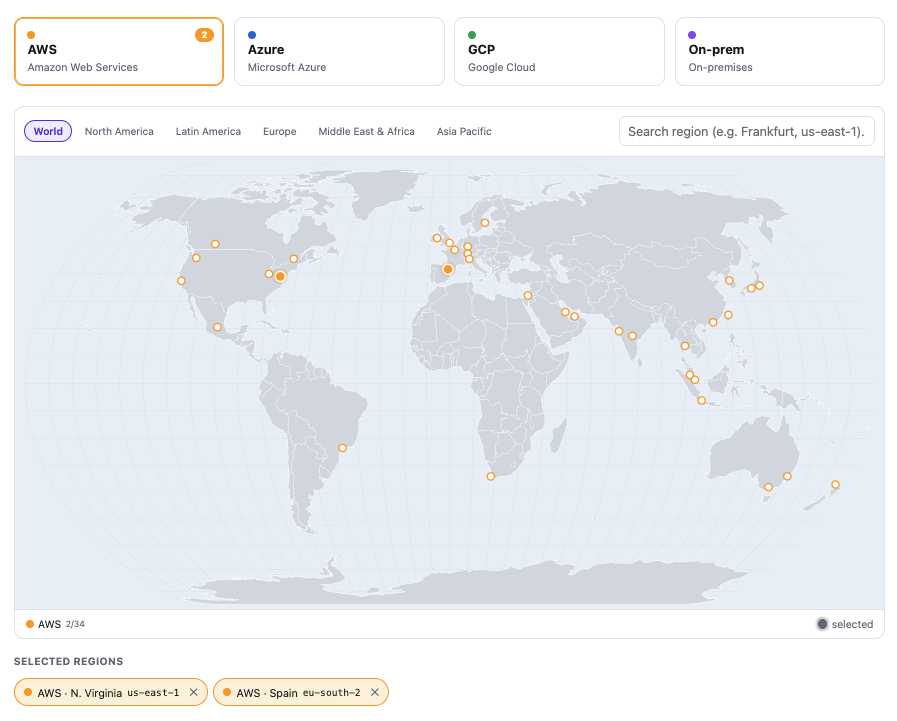
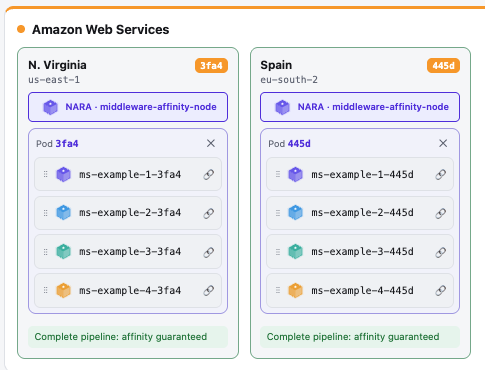
Por fim, o dashboard monta um quadro em que cada região recebe uma réplica do NARA e uma cópia completa do pipeline, com a afinidade garantida, e exporta o docker-compose correspondente, já com as restrições que fixam cada pipeline no seu nó.
Como eu testei
Para medir o efeito do NARA, eu construí um pipeline de referência: um sistema de publicação de imagens que extrai metadados, normaliza e grava o resultado. Ele foi propositalmente heterogêneo, misturando Java (Spring Boot) e Node.js:
| Serviço | Tecnologia | Porta | Responsabilidade |
|---|---|---|---|
| User Publication Service | Java Spring Boot | 8081 | Orquestra o pipeline e extrai os metadados da imagem |
| User Auth Service | Java Spring Boot | 8080 | Valida o usuário pelo UUID |
| Get Data | Node.js | 8083 | Recebe o payload e envia para a otimização |
| Optimize Data | Node.js | 8084 | Normaliza os metadados num documento estruturado |
| Upload Data | Node.js | 8085 | Grava o documento final no MongoDB |
Esse mesmo conjunto, com as mesmas imagens de container, portas e ordem, foi implantado com Docker Swarm em três infraestruturas bem diferentes:
| Ambiente | Configuração | Distribuição |
|---|---|---|
| AWS | 4× c7i-flex.large (2 vCPU / 4 GiB) | Virgínia (us-east-1) e Londres (eu-west-2) |
| Azure | 2× Standard D2s v3 (2 vCPU / 8 GiB) | América do Norte e Europa Central |
| On-premises | 2× Raspberry Pi 5 (8 GB de RAM) | Uma única rede local |
O cluster de Raspberry Pi tinha um papel importante no experimento. Nas nuvens, os nós estavam separados por links intercontinentais, então era de se esperar que evitar saltos entre eles trouxesse ganho. Numa rede local, um salto entre nós custa muito menos. Testar ali mostraria se o NARA ainda ajuda quando a distância é pequena.
Em cada ambiente, comparei dois cenários. No baseline, as requisições iam direto para o primeiro serviço do pipeline (porta 8081), com o roteamento inteiro nas mãos do Swarm. No cenário com o NARA, iam para o middleware (porta 3000). A aplicação era exatamente a mesma; só mudava a porta de entrada. Assim, qualquer diferença podia ser atribuída à estratégia de roteamento.
A carga foi gerada com o k6, a partir de uma máquina externa às três infraestruturas, em duas taxas (25 e 50 requisições por segundo) e três durações (180, 360 e 540 segundos). Cada uma dessas seis combinações rodou cinco vezes por ambiente e por cenário, e os resultados abaixo são a média das cinco execuções. Medi a latência média, a mediana e os percentis p90 e p95, além do número de requisições concluídas, que mostra se a vazão foi mantida.
Os resultados
O resumo cabe numa frase: o NARA reduziu a latência média em todas as 18 configurações testadas, de 33,3% a 48,8% na AWS, de 46,6% a 56,5% no Azure e de 14,4% a 58,8% no ambiente local, sem perder vazão. Mas cada ambiente contou uma história um pouco diferente.
AWS: ganho consistente, com um alerta
Na AWS, a latência média caiu de algo entre 500 e 650 ms para 255 a 433 ms. A mediana melhorou de 39,9% a 56,0%, e os percentis p90 e p95 caíram até 59,3% e 60,1%, ou seja, o NARA também encurtou a cauda da distribuição, aquelas requisições mais lentas que mais incomodam o usuário. O número de requisições concluídas variou no máximo 2,4% entre os cenários.
- −33%25/180
- −46%25/360
- −43%25/540
- −37%50/180
- −39%50/360
- −49%50/540
| Carga (req/s / s) | Base (ms) | NARA (ms) | Redução média | Mediana | p90 | p95 | Requisições (base) | Requisições (NARA) |
|---|---|---|---|---|---|---|---|---|
| 25/180 | 649,6 | 433,1 | 33,3% | 39,9% | 23,3% | 18,8% | 4.226 | 4.325 |
| 25/360 | 517,9 | 282,2 | 45,5% | 48,5% | 59,3% | 60,1% | 8.997 | 8.996 |
| 25/540 | 531,5 | 303,7 | 42,9% | 48,2% | 59,3% | 50,2% | 13.459 | 13.467 |
| 50/180 | 602,0 | 379,9 | 36,9% | 46,1% | 33,3% | 38,0% | 8.793 | 8.921 |
| 50/360 | 504,9 | 309,1 | 38,8% | 56,0% | 48,0% | 14,3% | 17.903 | 17.597 |
| 50/540 | 498,5 | 255,4 | 48,8% | 55,6% | 55,9% | 59,8% | 26.927 | 26.959 |
Dois pontos merecem atenção. Em 50 req/s por 360 s, o p95 melhorou só 14,3% porque uma das cinco execuções com o NARA teve uma degradação passageira (p95 de 1.847 ms, contra cerca de 330 ms nas outras), o que também explica a barra de desvio maior no gráfico. E em 50 req/s por 540 s, três das cinco execuções com o NARA devolveram erros HTTP 500, numa taxa média de 17,32%. Recalculando só com as respostas bem-sucedidas, a latência média foi de 498,55 ms no baseline para 269,39 ms com o NARA, uma redução de 45,97%. O ganho continua lá, mas o erro é um sinal importante, e eu volto a ele mais adiante.
Azure: os ganhos mais altos e estáveis
O Azure foi onde o NARA brilhou mais. A latência média caiu de 728 a 792 ms para 325 a 421 ms, uma redução de 46,6% a 56,5%. Em 25 req/s por 360 s, por exemplo, foi de 763,59 ms para 331,93 ms. A mediana melhorou de 41,5% a 68,5%, o p90 de 52,5% a 55,2% e o p95 de 57,0% a 67,1%, as faixas mais estreitas entre os três ambientes. Não houve nenhuma requisição com falha.
- −56%25/180
- −56%25/360
- −53%25/540
- −56%50/180
- −53%50/360
- −47%50/540
| Carga (req/s / s) | Base (ms) | NARA (ms) | Redução média | Mediana | p90 | p95 | Requisições (base) | Requisições (NARA) |
|---|---|---|---|---|---|---|---|---|
| 25/180 | 733,0 | 325,0 | 55,7% | 68,1% | 53,3% | 58,0% | 4.459 | 4.492 |
| 25/360 | 763,6 | 331,9 | 56,5% | 68,5% | 53,2% | 61,6% | 8.667 | 8.991 |
| 25/540 | 746,3 | 353,9 | 52,6% | 59,6% | 52,6% | 58,1% | 13.480 | 13.484 |
| 50/180 | 792,4 | 349,3 | 55,9% | 67,1% | 55,2% | 67,1% | 8.547 | 8.970 |
| 50/360 | 727,9 | 339,1 | 53,4% | 66,5% | 52,5% | 58,4% | 17.950 | 17.979 |
| 50/540 | 788,1 | 421,2 | 46,6% | 41,5% | 54,3% | 57,0% | 26.905 | 26.951 |
Além de mais rápido, o NARA concluiu tantas ou mais requisições que o baseline em todas as configurações. Em 50 req/s por 180 s, o baseline completou 8.546,6 das 9.000 esperadas, contra 8.970,4 com o NARA (+5,0%). Faz sentido: nessa implantação, o roteamento padrão do Swarm atravessava com frequência o link entre a América do Norte e a Europa Central, e era justamente esse vaivém que o NARA eliminava.
On-premises: ganho até numa rede local
No cluster de Raspberry Pi apareceram dois comportamentos bem distintos. Em 25 req/s, os dois cenários trabalharam com folga, com latência média abaixo de 90 ms. Mesmo assim, o NARA reduziu a média de 14,4% a 33,3% (de 73,92 ms para 59,51 ms em 540 s, por exemplo) e cortou o p90 e o p95 de 25,3% a 65,5%. Ou seja: evitar saltos entre nós compensa até dentro de uma rede local.
- −14%25/180
- −33%25/360
- −20%25/540
- −59%50/180
- −47%50/360
- −33%50/540
| Carga (req/s / s) | Base (ms) | NARA (ms) | Redução média | Mediana | p90 | p95 | Requisições (base) | Requisições (NARA) |
|---|---|---|---|---|---|---|---|---|
| 25/180 | 77,7 | 66,5 | 14,4% | 14,5% | 25,3% | 24,2% | 4.501 | 4.500 |
| 25/360 | 89,6 | 59,8 | 33,3% | 18,3% | 41,9% | 65,5% | 8.974 | 9.001 |
| 25/540 | 73,9 | 59,5 | 19,5% | 16,4% | 32,3% | 38,8% | 13.501 | 13.501 |
| 50/180 | 928,5 | 383,0 | 58,8% | 71,7% | 40,2% | 32,8% | 7.993 | 8.834 |
| 50/360 | 1.003,2 | 533,1 | 46,9% | 55,9% | 36,8% | 29,8% | 15.503 | 17.424 |
| 50/540 | 1.013,8 | 680,3 | 32,9% | 41,2% | 30,5% | 18,0% | 23.287 | 25.593 |
Em 50 req/s, o baseline saturou: a latência média subiu para 928 a 1.014 ms, e ele concluiu só 7.992,8, 15.502,8 e 23.286,8 requisições nos testes de 180, 360 e 540 s, bem abaixo das 9.000, 18.000 e 27.000 esperadas. Nas mesmas condições, o NARA reduziu a latência média em 58,8%, 46,9% e 32,9% e completou 10,5%, 12,4% e 9,9% mais requisições. O ganho diminuiu conforme o teste ficou mais longo, e a variação entre as execuções cresceu (desvio padrão de até 231 ms): sob carga pesada e contínua, o hardware limitado dos Raspberry Pi acaba segurando os dois cenários.
Os três ambientes lado a lado
Colocando tudo junto, o Azure teve as reduções mais altas e estáveis, a AWS veio em seguida, com mais variação nos percentis de cauda, e o ambiente local teve as menores reduções médias, mas a maior amplitude: lá, o NARA ora melhorava uma latência que já era baixa, ora ajudava um cluster saturado a dar conta da carga.
- AWS
- Azure
- On-premises
| Ambiente | Média | Mediana | p90 | p95 |
|---|---|---|---|---|
| AWS | 41,0% (33,3–48,8) | 49,1% (39,9–56,0) | 46,5% (23,3–59,3) | 40,2% (14,3–60,1) |
| Azure | 53,4% (46,6–56,5) | 61,9% (41,5–68,5) | 53,5% (52,5–55,2) | 60,0% (57,0–67,1) |
| On-premises | 34,3% (14,4–58,8) | 36,4% (14,5–71,7) | 34,5% (25,3–41,9) | 34,8% (18,0–65,5) |
Redução média nas seis configurações de carga; entre parênteses, a menor e a maior redução observada.
Em todos os ambientes, o número de requisições concluídas com o NARA foi igual ou maior que no baseline. E o fato de o ganho aparecer em três infraestruturas tão diferentes (duas nuvens públicas com regiões em continentes distintos e um cluster de computadores de placa única) é o argumento mais forte a favor da generalidade da abordagem: o benefício vem da estratégia de roteamento, não de um provedor ou de um hardware específico.
O que os números não dizem
Seria desonesto apresentar só a parte boa. Alguns cuidados para interpretar esses resultados:
- O gargalo muda de lugar. Os erros HTTP 500 na AWS em 50 req/s por 540 s mostram o outro lado da afinidade: ao concentrar o pipeline inteiro de cada requisição no nó que a recebeu, o NARA pode sobrecarregar os serviços daquele nó sob carga alta e sustentada. Afinidade e capacidade precisam ser pensadas juntas.
- Um único pipeline. Os testes usaram uma cadeia de cinco serviços, quase toda sequencial. Arquiteturas com mais chamadas em paralelo, mensageria assíncrona ou eventos podem sentir o efeito de outro jeito.
- Docker Swarm. Parte da estratégia de implantação depende de mecanismos específicos do Swarm, como as restrições de posicionamento. Levar o NARA para o Kubernetes exigiria adaptar a forma de descobrir a topologia.
- Ruído da nuvem. Nas nuvens públicas há fatores que a gente só controla em parte, como a disputa por recursos no mesmo host e a variação dos links entre data centers. Repetir cada configuração cinco vezes ajuda, mas não elimina.
- Máquinas pequenas. As instâncias usadas eram modestas. Em máquinas de produção, os números absolutos podem ser outros, ainda que a vantagem de evitar tráfego desnecessário entre nós deva continuar.
Fechando: menos distância, menos espera
A lição que tiro desse trabalho é que nem toda otimização de desempenho precisa vir de mais máquinas, mais réplicas ou mais infraestrutura. Às vezes, o ganho está em algo mais simples: não mandar a requisição para longe quando dá para resolver ali mesmo. Um componente pequeno, sem estado e que não sabe nada da regra de negócio conseguiu reduzir a latência de forma consistente em duas nuvens públicas e num cluster local de Raspberry Pi, sem sacrificar a vazão.
O roteamento consciente da topologia não substitui as estratégias tradicionais de escala e orquestração, mas as complementa bem. Os próximos passos que vejo são testar o NARA com arquiteturas orientadas a eventos e com mais paralelismo, levá-lo para o Kubernetes e ampliar a avaliação para além da latência: consumo de recursos, energia, custo operacional e comportamento em implantações de produção em larga escala.
O código do middleware e do pipeline de testes está aberto no GitHub, e os links estão nas fontes, no fim do artigo.
Fontes
- NARA: código-fonte do middleware (middleware-affinity-node)GitHub
- NARA: pipeline de microsserviços usado nos testes (nara-ms-benchmarking)GitHub
- Performance comparison of service mesh frameworks: the mTLS test caseBremler-Barr et al., arXiv, 2024
- A distributed tracing pipeline for improving locality awareness of microservices applicationsColarusso et al., Software: Practice and Experience, 2024
- Latency aware graph-based microservice placement in the edge-cloud continuumKhan e Khan, Cluster Computing, 2025
- Load-balancing of Kubernetes-based edge computing infrastructure using resource adaptive proxyNguyen, Phan e Kim, Sensors, 2022
- QEdgeProxy: QoS-aware load balancing for IoT services in the computing continuumČilić et al., IEEE EDGE, 2024
- Serverless computing: state-of-the-art, challenges and opportunitiesLi et al., IEEE Transactions on Services Computing, 2023