Do mainframe ao bolso: como o hardware barato simplificou o software e digitalizou o mundo
Resumo
Toda arquitetura de software é uma resposta à pergunta "o que está caro hoje?". Uma viagem década a década, do mainframe ao bolso, explicando o que cada paradigma é por dentro e como o hardware barato levou a tecnologia a cada vez mais gente.
- arquitetura de software
- história da computação
- microsserviços
- trade-offs
Uma conversa sobre caixas e setas
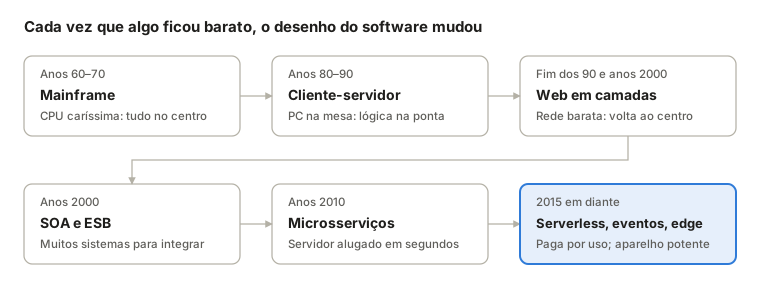
Toda arquitetura de software é uma resposta à pergunta “o que está caro hoje?”. Quando o computador custava milhões, a gente economizava máquina. Quando a máquina ficou barata, passamos a economizar gente, tempo e coordenação. Essa troca explica quase tudo o que vou contar aqui.
E tem um efeito colateral maravilhoso nisso tudo: cada vez que o hardware barateou, mais gente passou a ter acesso à tecnologia. O computador que antes só um banco ou uma universidade podia pagar foi parar na mesa do escritório, depois na sala de casa e, por fim, no bolso de bilhões de pessoas. E cada nova leva de usuários obrigou o software a se reinventar para atender mais gente, em mais lugares, ao mesmo tempo.
Já desenhei muita caixinha com seta em quadro branco, e demorei a perceber que os estilos de arquitetura não aparecem por moda. Eles aparecem porque o hardware mudou de preço, a rede ficou mais rápida e, de repente, uma ideia que era absurda passou a fazer sentido.
Neste texto eu quero fazer duas coisas. Primeiro, contar essa história década a década, de um jeito leve. Depois, explicar de forma simples o que cada paradigma é por dentro: quem conversa com quem, onde moram os dados e o que você ganha ou perde ao escolher cada um.
Anos 60 e 70: um cérebro só, muitas telas burras
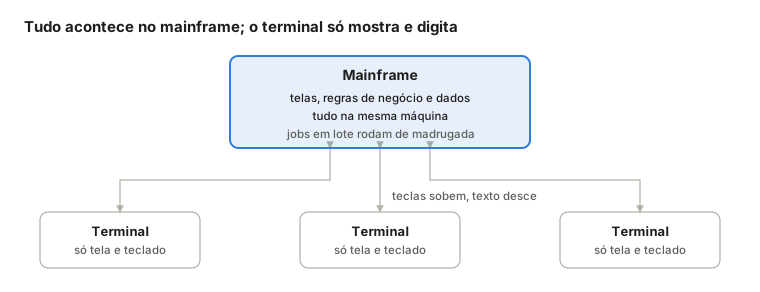
No começo, existia uma máquina enorme no centro, o mainframe, e todo mundo dependia dela. Ela ocupava uma sala refrigerada, custava uma fortuna e era alugada por hora de processamento. Os usuários sentavam diante de terminais que só mostravam texto e mandavam teclas de volta.
O paradigma aqui é o monolito centralizado. Tecnicamente, é simples de entender:
- Tudo roda no mesmo lugar: tela, regra de negócio e dados vivem no mainframe.
- O terminal não pensa: ele só desenha caracteres e envia o que foi digitado.
- Processamento em lote (batch): boa parte do trabalho rodava de madrugada, em filas de jobs, porque o tempo de CPU era precioso demais para desperdiçar durante o dia.
Fazia todo sentido. Se você só pode comprar um computador, você coloca tudo nele e otimiza cada ciclo. O lado ruim também é óbvio: um ponto único de falha, mudanças lentas e uma fila de gente esperando a vez de usar a máquina.
Anos 80 e 90: o computador vai para a mesa
Aí veio o microcomputador, e com ele uma virada de chave. Pela primeira vez, a máquina na mesa de cada pessoa tinha processador, memória e disco próprios. Desperdiçar esse poder usando o PC só como terminal parecia bobagem.
Nasce o cliente-servidor. A ideia é dividir o trabalho em dois:
- Cliente: o programa instalado no PC cuida da interface gráfica e de boa parte da lógica, como validações e cálculos.
- Servidor: uma máquina central, geralmente com o banco de dados relacional, guarda os dados e responde a consultas SQL pela rede local.
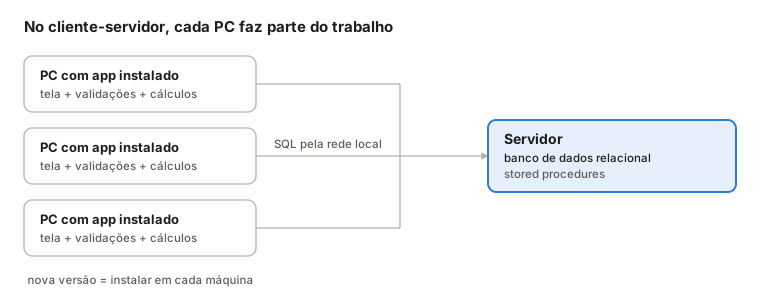
Eu lembro bem do lado bom e do lado ruim disso. As telas ficaram ricas e rápidas, porque o processamento estava ali do lado do usuário. Em compensação, atualizar o sistema significava passar de máquina em máquina instalando a nova versão, e a regra de negócio acabava espalhada entre o cliente e as stored procedures do banco.
Repare no padrão: o hardware ficou barato o bastante para cada pessoa ter o seu, e a arquitetura imediatamente empurrou trabalho para a ponta.
Fim dos anos 90 e anos 2000: a web e as camadas
Com a internet, o pêndulo voltou para o centro, só que de um jeito diferente. O navegador virou um “terminal” universal: ninguém precisava mais instalar nada, bastava abrir uma URL. E os servidores, agora máquinas x86 relativamente baratas, podiam ser empilhados num data center.
O paradigma dominante passa a ser a arquitetura em camadas (o famoso 3-tier). Cada camada tem uma responsabilidade e só conversa com a vizinha:
- Apresentação: o que o usuário vê, HTML no navegador.
- Aplicação ou negócio: as regras, rodando num servidor de aplicação (Java, .NET, PHP).
- Dados: o banco, isolado atrás da camada de negócio.
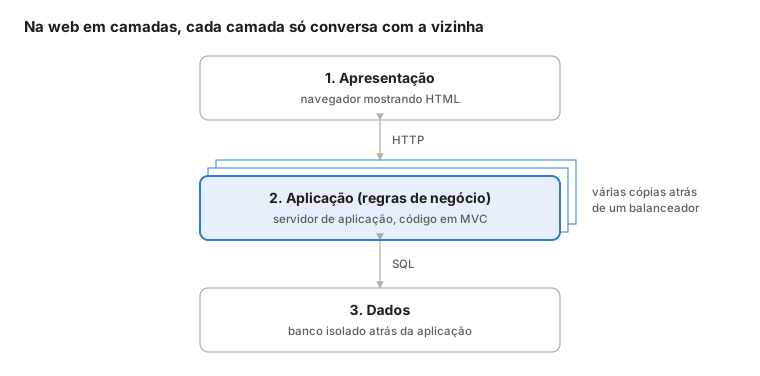
Dentro da aplicação, padrões como o MVC (Model, View, Controller) organizavam o código do mesmo jeito: separar o que se mostra do que se decide e do que se guarda.
O ganho foi enorme. Atualizar o sistema virou trocar arquivos num servidor, e dava para colocar várias cópias da camada de aplicação atrás de um balanceador de carga. Mas o deploy ainda era um bloco único: mexer numa tela pequena exigia publicar o sistema inteiro. Era um monolito, só que bem organizado por dentro.
Anos 2000: SOA e o grande barramento
As empresas acumularam muitos sistemas: o ERP, o CRM, o faturamento, o sistema legado do mainframe que ninguém tinha coragem de desligar. O problema deixou de ser “como construir um sistema” e virou “como fazer vinte sistemas conversarem”.
A resposta foi a SOA, ou Arquitetura Orientada a Serviços. Em termos simples:
- Cada sistema expõe suas capacidades como serviços com um contrato bem definido, geralmente em XML via SOAP e descrito em WSDL.
- No meio de tudo fica um ESB (Enterprise Service Bus), um barramento que roteia mensagens, traduz formatos e orquestra chamadas entre os serviços.
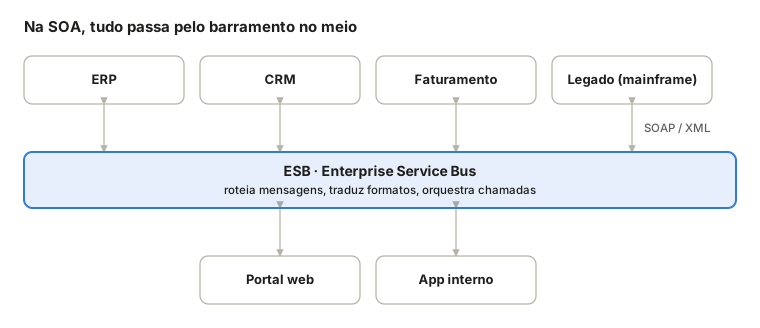
A intenção era ótima: reaproveitar funções do negócio em vez de reescrevê-las. Na prática, eu vi muito ESB virar o novo gargalo, com regras de negócio escondidas no barramento e um time central que precisava aprovar tudo. A ideia de serviço sobreviveu; o barramento gigante, nem tanto.
Anos 2010: nuvem, containers e microsserviços
Esta é a virada que mais mudou o meu dia a dia. Com a nuvem, um servidor deixou de ser uma compra com meses de espera e virou uma chamada de API que leva segundos e é cobrada por hora. Hardware passou a ser algo que você aluga, liga e desliga.
Quando a máquina custa quase nada, o recurso escasso passa a ser outro: a coordenação entre pessoas. Um monolito com 200 desenvolvedores mexendo no mesmo código vira um engarrafamento. Daí os microsserviços:
- O sistema é quebrado em serviços pequenos e independentes, cada um cuidando de uma parte do negócio (pedidos, pagamentos, catálogo).
- Cada serviço tem o seu próprio banco de dados. Ninguém lê a tabela do outro; conversa-se por API, normalmente REST/JSON ou gRPC.
- Cada um é publicado separadamente, empacotado em um container (Docker) e orquestrado por plataformas como o Kubernetes.
- Um API Gateway fica na porta de entrada, recebendo as chamadas dos apps e distribuindo para os serviços certos.
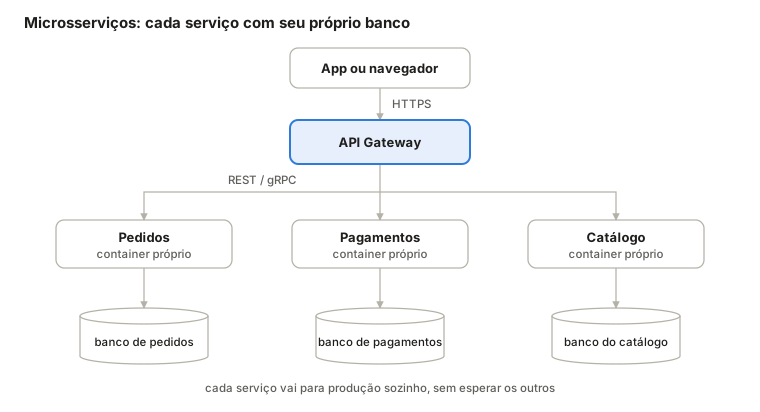
A diferença para a SOA é sutil, mas importante: em vez de um barramento esperto no centro, temos serviços espertos e canos burros. A inteligência fica nas pontas.
O preço disso é a complexidade distribuída. Uma chamada que antes era uma função na memória agora atravessa a rede e pode falhar. Você precisa de observabilidade, retentativas, versionamento de APIs e um time maduro para operar tudo. Para um time de cinco pessoas, muitas vezes é mais problema do que solução.
De 2015 para cá: serverless, eventos e a borda
Se na nuvem eu alugava servidores por hora, no serverless eu nem vejo mais o servidor. Escrevo uma função, digo quando ela deve rodar, e o provedor cuida do resto. Pago por execução, às vezes por milissegundo, e quando ninguém usa, o custo cai perto de zero.
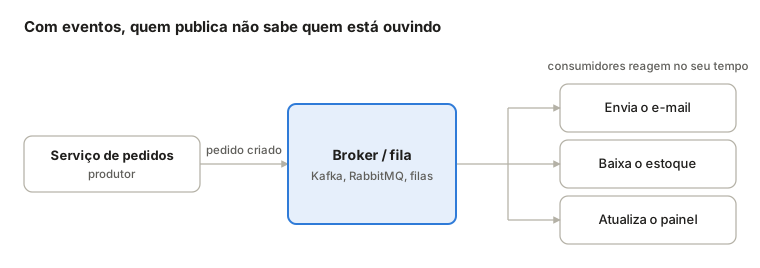
Junto com isso, ganhou força a arquitetura orientada a eventos. Em vez de um serviço chamar o outro e esperar a resposta, ele publica um fato: “pedido criado”. Quem se interessa por esse fato reage no seu próprio tempo:
- Produtores publicam eventos num broker ou fila (Kafka, RabbitMQ, filas gerenciadas da nuvem).
- Consumidores se inscrevem e reagem: um envia o e-mail, outro baixa o estoque, outro atualiza o painel.
- Ninguém precisa saber quem está ouvindo. Isso reduz o acoplamento e deixa o sistema crescer por adição.
E tem a borda (edge). Celulares e dispositivos ficaram tão potentes e baratos que voltamos a processar na ponta: código rodando em CDNs perto do usuário, apps que funcionam offline e sincronizam depois, até modelos de IA rodando no próprio aparelho. O pêndulo, mais uma vez, se mexeu.
Os paradigmas lado a lado
Se eu tivesse que resumir cada estilo numa linha, seria assim:
| Paradigma | Onde roda a lógica | Onde moram os dados | Como as partes conversam | Ganha | Paga |
|---|---|---|---|---|---|
| Monolito centralizado | Num único computador central | No mesmo computador | Chamadas internas, na memória | Simplicidade, consistência | Ponto único de falha, mudança lenta |
| Cliente-servidor | Dividida entre PC e servidor | Banco central | SQL pela rede local | Telas ricas e rápidas | Instalar e atualizar em cada máquina |
| Camadas (3-tier / MVC) | Servidor de aplicação | Banco atrás da aplicação | HTTP entre camadas vizinhas | Organização, deploy central | Deploy ainda é um bloco só |
| SOA | Serviços corporativos | Cada sistema com o seu | Mensagens via barramento (ESB) | Reuso entre sistemas | Barramento vira gargalo |
| Microsserviços | Muitos serviços pequenos | Um banco por serviço | APIs REST/gRPC | Times e deploys independentes | Complexidade de sistema distribuído |
| Serverless e eventos | Funções disparadas sob demanda | Serviços gerenciados | Eventos em filas e brokers | Escala automática, paga pelo uso | Depuração difícil, dependência do provedor |
Um detalhe que gosto de reforçar: nenhum desses estilos morreu. Mainframes ainda processam transações de bancos, monolitos bem feitos seguem rodando empresas enormes, e a maior parte dos sistemas reais é uma mistura de dois ou três estilos.
O fio condutor: o que fica barato muda o desenho
Olhando para trás, eu enxergo um movimento de pêndulo. Ele oscila entre concentrar o processamento num lugar e espalhar o processamento pelas pontas. E quem empurra o pêndulo é quase sempre o preço de três coisas: processador, armazenamento e rede.
- Processador caro → centraliza tudo e aproveita cada ciclo (mainframe).
- Processador barato na mesa → empurra trabalho para o cliente (cliente-servidor).
- Rede barata e onipresente → volta a centralizar, mas atrás de um navegador (web em camadas).
- Servidor alugável em segundos → quebra o sistema em muitos pedaços independentes (microsserviços).
- Computação cobrada por execução → nem pensa mais em servidor (serverless).
- Dispositivos potentes no bolso → processa de novo na ponta (edge, IA no aparelho).
Tem um efeito curioso aqui. Cada vez que o hardware barateia, o gargalo muda de lugar: sai da máquina e vai para as pessoas. Hoje, o que mais custa num projeto raramente é o servidor; é o tempo do time, a velocidade para mudar e a dificuldade de coordenar dezenas de pessoas no mesmo código. As arquiteturas modernas são, no fundo, ferramentas para organizar gente.
Mais barato, mais gente, mais escala
O outro lado dessa moeda é o acesso. Cada queda de preço ampliou o círculo de quem usa tecnologia:
- Mainframe: governos, bancos, grandes empresas e universidades, e só especialistas na frente da tela.
- PC: empresas de todos os tamanhos e, depois, as famílias em casa.
- Internet: qualquer pessoa com um navegador, sem instalar nada.
- Nuvem: qualquer desenvolvedor com um cartão de crédito tem a infraestrutura de uma grande empresa.
- Smartphone: bilhões de pessoas com um computador no bolso, muitas delas tendo ali o seu primeiro computador.
E aqui o ciclo se fecha. Mais gente usando significa mais acessos simultâneos, mais dados e mais variedade de aparelhos. É isso que força a arquitetura a evoluir de novo. O hardware barato abre a porta, as pessoas entram, e o software precisa crescer para caber todo mundo.
Para fechar: não existe arquitetura vencedora
Se tem uma coisa que aprendi desenhando sistemas é que a pergunta “qual é a melhor arquitetura?” não tem resposta. A pergunta certa é “o que está caro para mim agora?”. Pode ser o servidor, pode ser a latência, pode ser o tamanho do time ou o prazo.
O que aprendi com “As partes difíceis”
Quem me ajudou a colocar isso em palavras foi o livro Arquitetura de Software: As Partes Difíceis, de Neal Ford, Mark Richards, Pramod Sadalage e Zhamak Dehghani. A ideia central do livro é desconfortável e libertadora ao mesmo tempo: em arquitetura, não existe receita pronta que sirva para todo mundo.
Os autores insistem que tudo em arquitetura é um trade-off, uma troca. Cada decisão que melhora uma coisa piora outra. Separar um banco de dados dá autonomia aos times, mas complica a consistência das transações. Quebrar um serviço em dois facilita o deploy, mas aumenta as chamadas pela rede. Não dá para ter tudo.
Por isso o livro propõe uma mudança de postura que eu adotei: em vez de procurar a melhor arquitetura, procure a combinação menos ruim de trade-offs para o seu contexto. E contexto é algo que só a sua empresa tem: o tamanho do time, o orçamento, o volume de acessos, as regras do negócio, o legado que já existe, a pressa do mercado.
É por isso que copiar a arquitetura da Netflix ou de qualquer gigante raramente dá certo. Aquele desenho resolveu os problemas deles, com as restrições deles. Uma arquitetura não se replica como um modelo; ela se constrói a partir de perguntas sobre o seu próprio negócio. O livro, aliás, faz isso na prática: acompanha um time fictício tomando decisões difíceis, e mostra que a resposta quase sempre começa com “depende”.
Uma startup com quatro pessoas provavelmente vai mais longe com um monolito bem organizado. Uma empresa com cem times precisa de fronteiras claras entre serviços. Um app que precisa funcionar no meio do mato, sem sinal, vai processar no aparelho.
O hardware vai continuar barateando, mais gente vai continuar chegando, e o pêndulo vai continuar se mexendo. A melhor coisa que a gente pode fazer é entender por que cada estilo nasceu. Assim, quando a próxima mudança de preço chegar, a gente reconhece o movimento antes de ele virar moda.